

版本:2026 最新版
分类:图像软件
时间:2026-09-20 11:45
大小:9.1M
等级:
环境:WinAll
授权:免费软件
语言:中文
PDF猫OCR文字识别是一款专为电脑端打造的智能文档处理工具,集成了先进的OCR光学字符识别引擎,能够精准提取PDF、图片中的文字信息,并支持批量转换、格式还原、多语言识别等实用功能。软件界面简洁直观,操作流程一键式,无需复杂设置,即便是初次接触的用户也能快速上手。无论是扫描件、截图还是拍照图片,PDF猫都能高效识别并输出可编辑的文本,极大提升办公与学习效率,是处理电子文档不可或缺的得力助手。
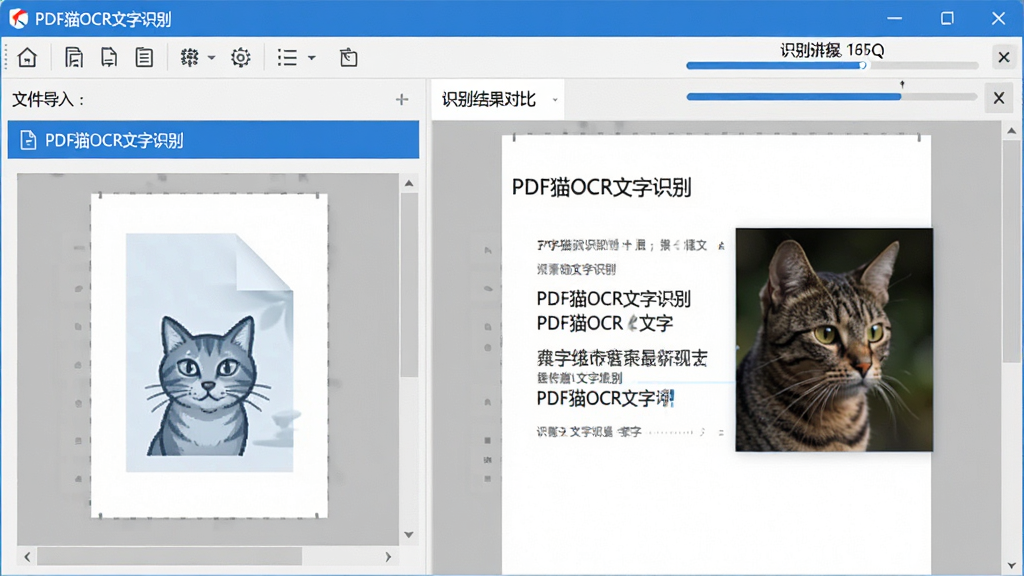
PDF猫内置了基于深度学习算法的高精度OCR引擎,对印刷体、手写体及复杂背景下的文字均有出色的识别表现。支持中、英、日、韩等多国语言混排识别,准确率高达98%以上,即使是低分辨率扫描件也能还原清晰文本。识别后的文字保留原始排版格式,可直接复制、编辑或导出为Word、TXT等格式,满足不同场景的文档处理需求。
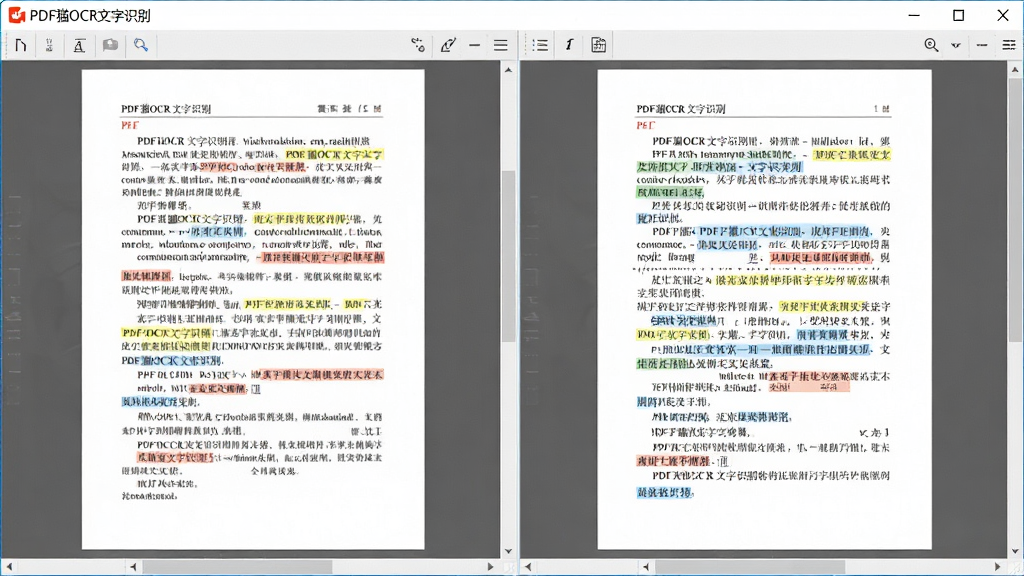
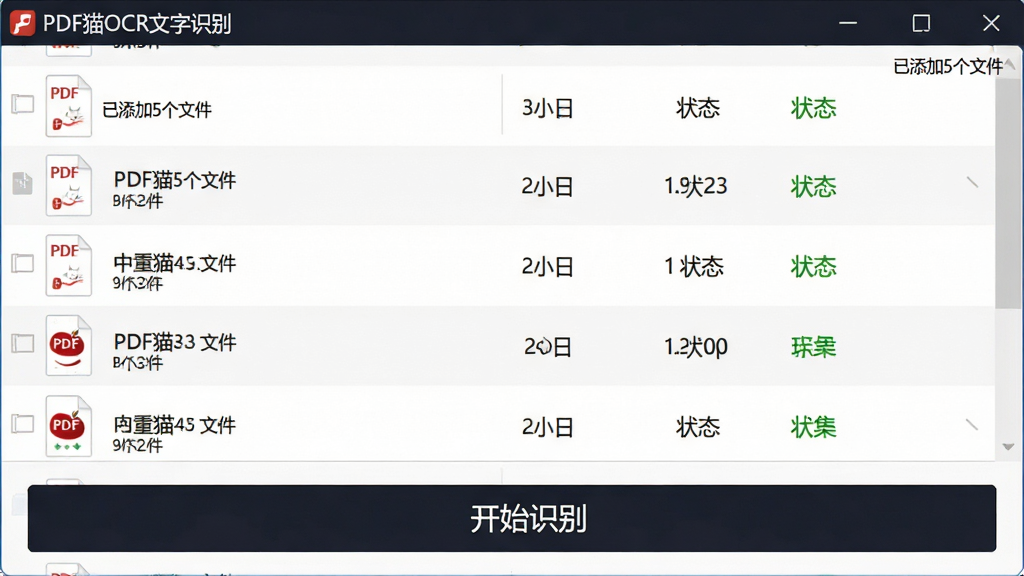
软件支持批量导入PDF或图片文件,一次性完成多份文档的文字识别与转换。用户可自定义输出格式、识别语言及保存路径,处理过程自动排队执行,无需人工干预。针对大量纸质材料电子化的需求,PDF猫能够快速完成扫描件的批量OCR,显著节省时间成本,适合企业、学校及个人用户高效办公。
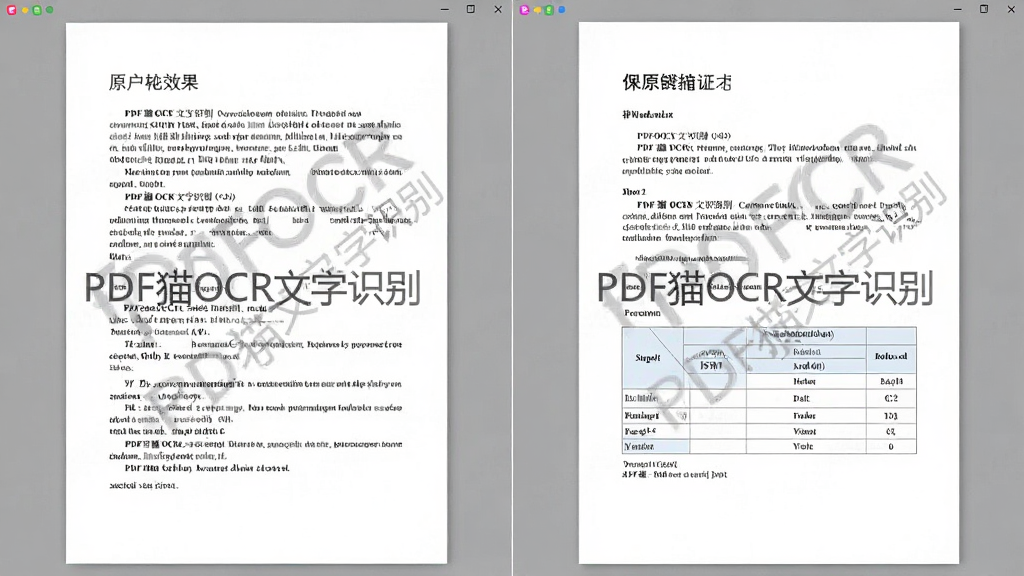
识别后的文字能够智能还原原始文档的段落、表格、列表等结构,保留字体、字号、颜色等基础样式。用户无需手动调整即可获得接近原版的电子文档,极大简化了二次编辑工作。同时支持将识别结果直接导出为PDF、Word、Excel等常用格式,方便后续存储、打印或分享。
内置多语言识别库,支持超过20种语言的文字提取,并可与主流翻译工具无缝衔接,实现“识别-翻译-导出”一站式操作。对于需要处理外文文献、国际合同的用户,PDF猫能快速提取原文并进行翻译,大幅降低语言门槛,提升工作效率。
所有识别操作均在本地完成,文件无需上传至云端,杜绝隐私泄露风险。软件不收集用户任何文档信息,离线也能正常使用,特别适合处理合同、身份证、银行流水等敏感文件,为用户数据安全提供坚实保障。
| 项目 | 说明 |
|---|---|
| 适用系统 | Windows 7/8/10/11(32位/64位) |
| 运行环境 | 需安装.NET Framework 4.5及以上版本 |
| 文件格式 | 支持PDF、JPG、PNG、BMP、TIFF等常见格式 |
| 输出格式 | TXT、Word、Excel、PDF(可编辑) |
| 识别语言 | 简体中文、繁体中文、英文、日文、韩文等20+语言 |
| 批量限制 | 单次最多可处理50个文件 |
| 网络要求 | 离线可用,无需联网 |
| 硬件建议 | CPU双核以上,内存4GB及以上 |
高危避坑:安装时务必从官网或正规应用商店下载,避免第三方捆绑插件。
优化技巧:在“设置”中开启“高精度模式”,可提升低清图片的识别率。
温馨提示:首次使用建议先体验“示例文件”,熟悉操作流程。
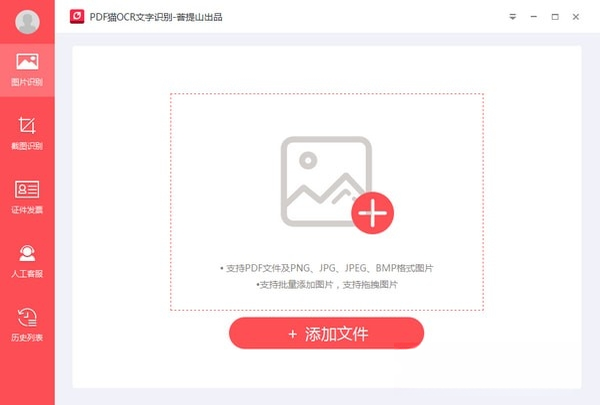
电脑端操作:双击桌面图标打开软件,点击“添加文件”导入PDF或图片,选择输出格式与语言,点击“开始识别”即可。处理完成后自动弹出结果预览,支持直接复制或导出。
移动端适配:本软件目前仅支持Windows电脑端,若需在手机或平板上使用,敬请期待后续版本。
安装避坑:安装路径不要包含中文或特殊字符,否则可能导致运行报错;关闭杀毒软件误报,添加信任白名单。
权限设置:若提示“无法写入文件”,请以管理员身份运行软件,并检查输出文件夹的写入权限。
存储选择:建议将输出目录设在C盘之外,避免系统盘空间不足影响运行。
运行优化:关闭后台不必要的程序,释放内存资源,可提升批量识别速度。
后台管控:若软件被安全软件拦截,请允许其所有操作,并开启“开机启动”以获得最佳体验。
使用禁忌:请勿用于识别违法违禁内容,尊重他人版权。
报错解决:若出现闪退,请更新显卡驱动并安装VC++运行库;若卡顿,请降低图片分辨率或分批次处理;若黑屏,请切换窗口模式或关闭硬件加速。
若提示缺少OCR组件,可前往本站搜索“OCR识别引擎”下载对应组件。
强制操作:识别前请确认文件未加密,否则无法提取文字。
优化技巧:对于表格类文档,建议选用“Excel”输出格式,可保留表格结构。
温馨提示:每天首次运行会加载语言包,请耐心等待。
若需要批量处理大量文件,建议使用“文件夹监视”功能,自动识别新添加的文件。
| 软件名称 | 功能优势 | 评分 |
|---|---|---|
| ABBYY FineReader | 专业OCR,支持180种语言 | ★★★★★ |
| Adobe Acrobat Pro | PDF编辑+OCR一体化 | ★★★★☆ |
| Readiris | 多语言识别,转换精准 | ★★★★☆ |
| 天若OCR | 免费开源,支持截图识别 | ★★★★☆ |
| PandaOCR | 多引擎聚合,接口丰富 | ★★★★☆ |
使用非常简单:下载并安装软件后,打开主界面,点击“添加文件”按钮选择需要识别的PDF或图片,在下方设置识别语言和输出格式,然后点击“开始识别”按钮即可。识别完成后会自动弹出结果窗口,你可以直接复制文字,也可以导出为Word或TXT文件。整个流程不到一分钟,无需任何技术基础。
完全安全。软件的所有识别操作都在本地电脑完成,文件不会上传到任何服务器,无需联网即可使用,因此不存在隐私泄露风险。同时软件本身不包含任何恶意代码,通过各大安全软件检测认证,可以放心使用。建议从官网或腾讯软件中心等正规渠道下载,避免下载到捆绑木马的盗版版本。
 迅捷OCR文字识别软件应用软件
 OCR文字识别助手应用软件
 转易侠OCR文字识别app办公商务
 PushClock安卓版生活服务
 准点闹钟CLOcK手机软件
 巴士快线游戏(Crowd Express)休闲益智
 PDF快速看图软件办公商务
 职业僵尸猎手2.5手机版(Occupation 2.5)飞行射击
 侦探八哥犬夏洛克安卓版(Detective Sherlock Pug)冒险解密
 SUSHI Crane游戏休闲益智
 云橙图片压缩软件
 艾奇KTV电子相册制作软件
 苹果HEIC图片转换器
 云橙苹果HEIC转JPG转换器
 云橙苹果
 墨刀
 蚂蚁画图
 dhf视频转换器
 迅捷去水印软件
 印章生成器 火箭水印
 Eagle
 吉吉看图